AI순위 진짜 기준은? 챗GPT·클로드·제미나이 비교와 목적별 선택법
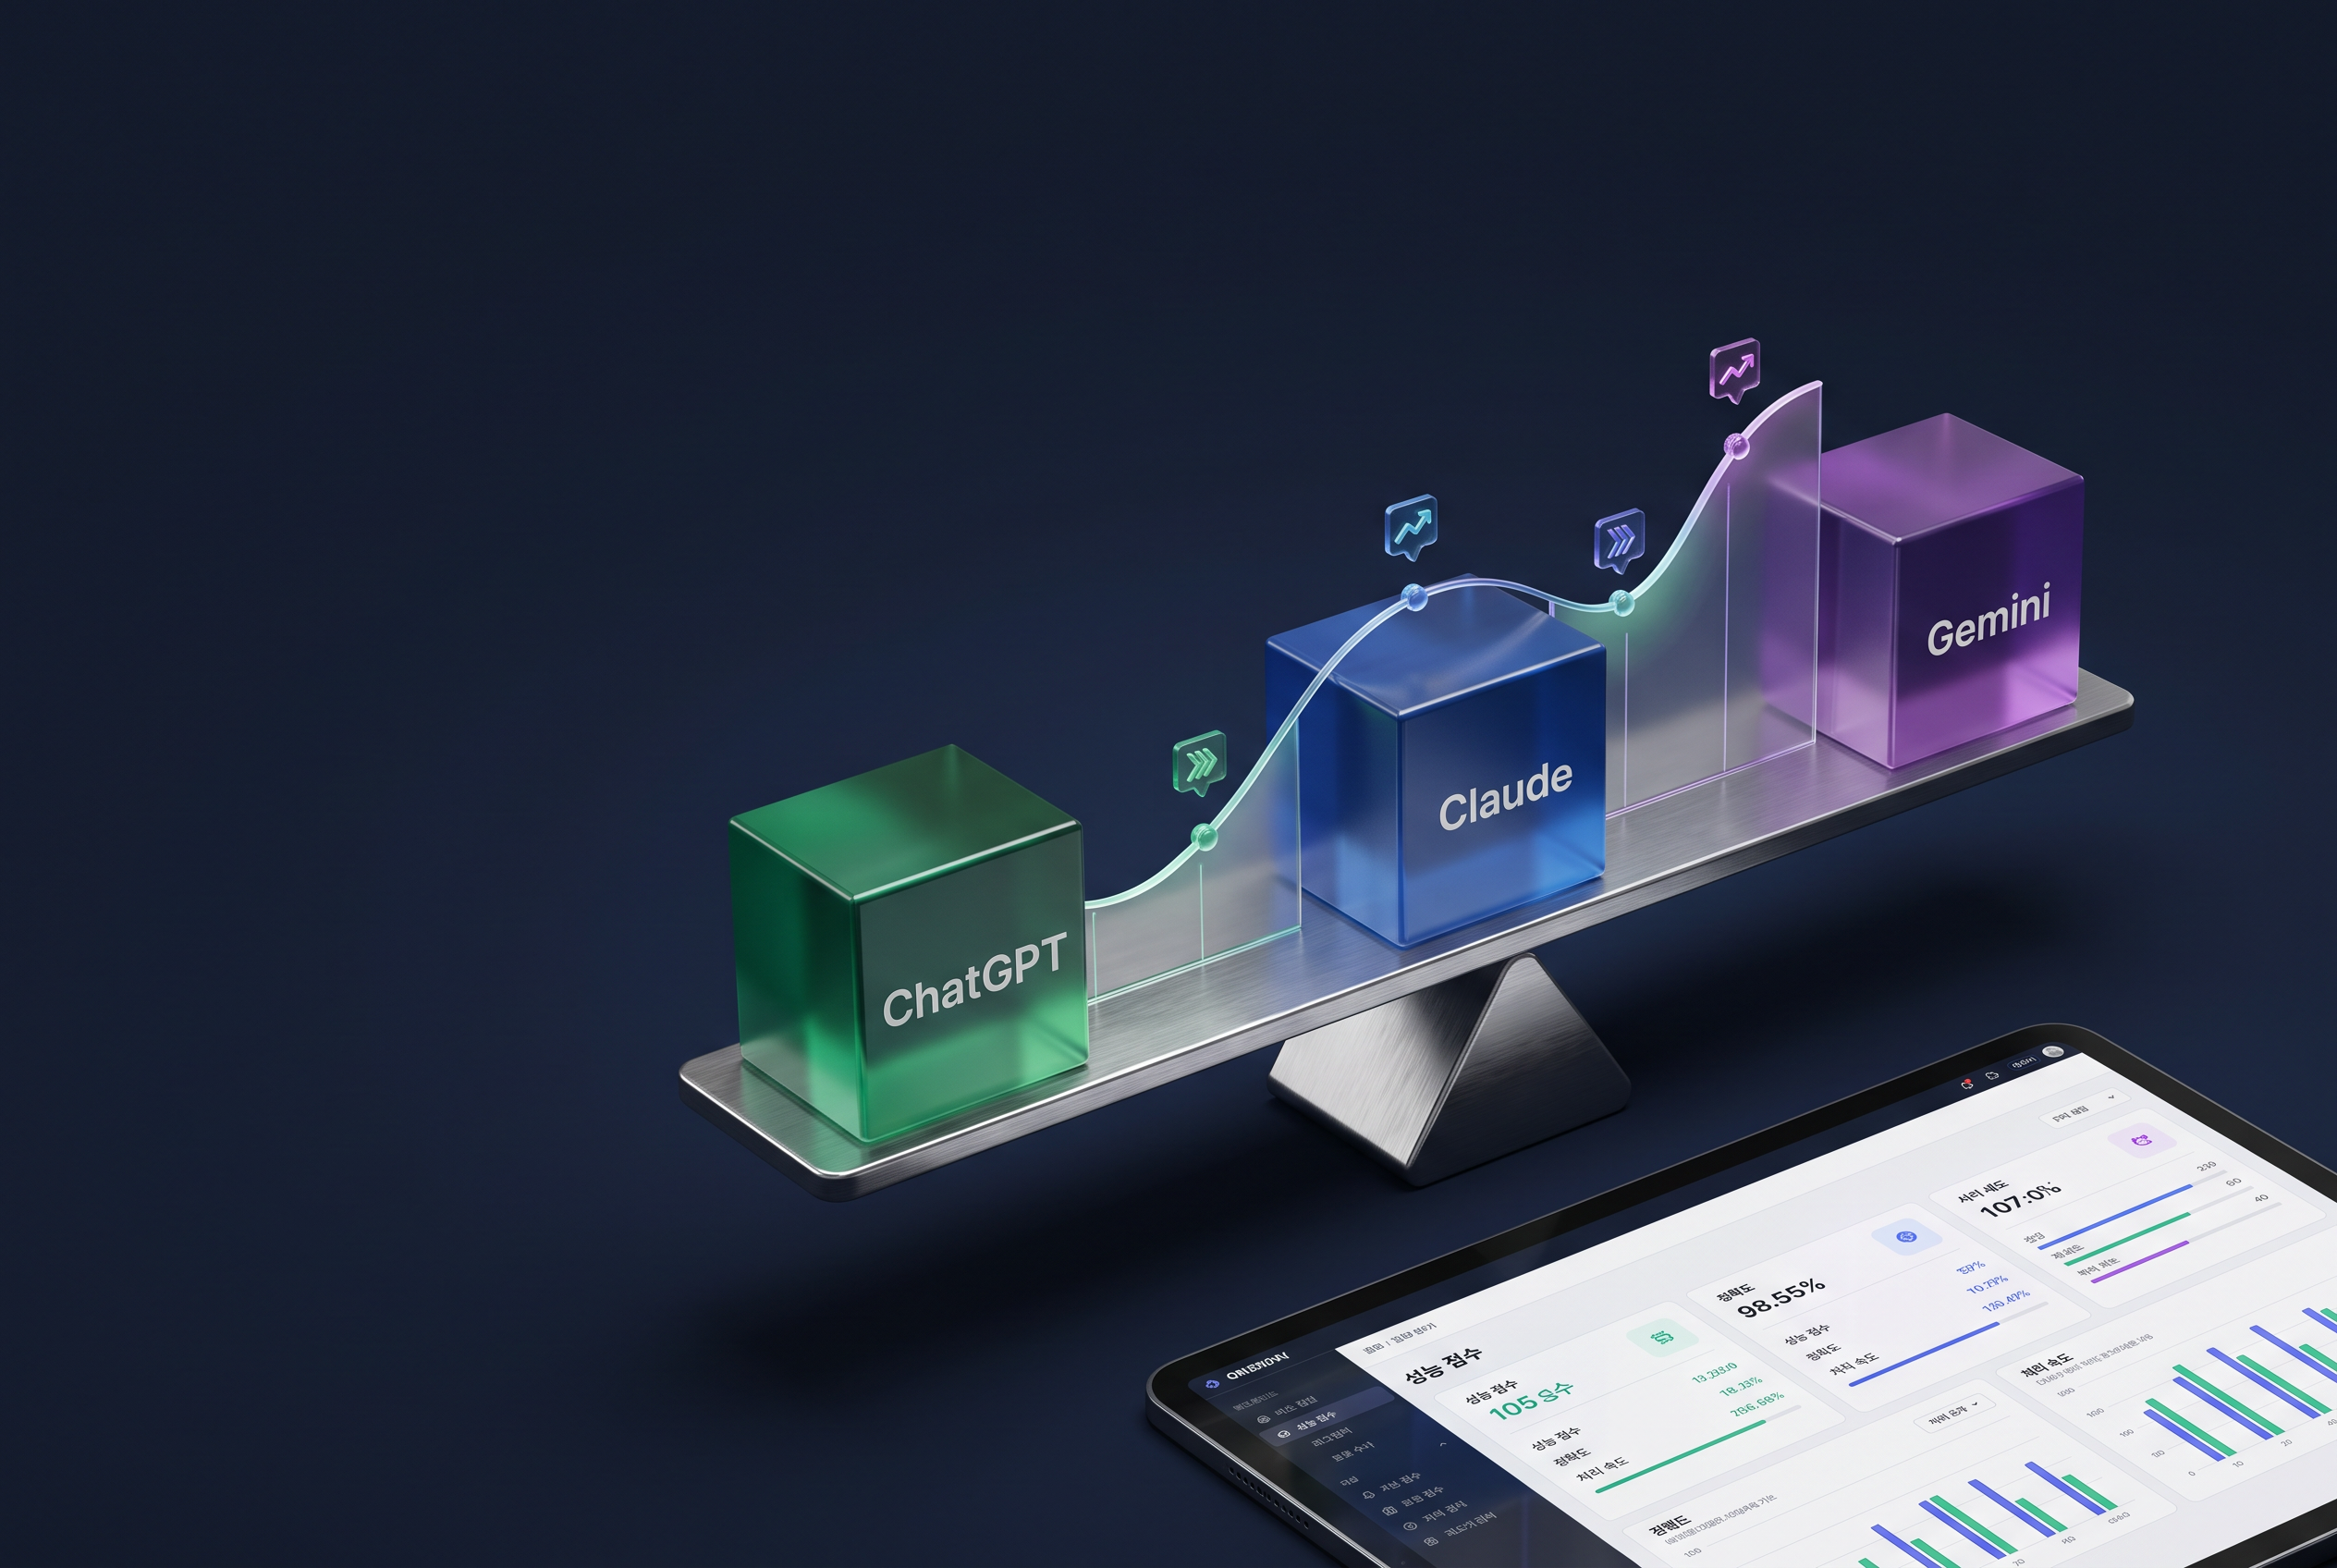
'지금 AI 1위가 챗GPT냐 클로드냐'는 질문에는 정답이 하나로 떨어지지 않는다. 어떤 기준으로 줄을 세우느냐에 따라 순위표 자체가 달라지기 때문이다. 트래픽으로 보면 챗GPT가 압도적이고, 코딩 벤치마크로 보면 클로드가 자주 상위에 오른다. 이 차이를 모르고 '1위'라는 단어만 보고 도구를 정하면, 정작 본인 작업에는 안 맞는 선택을 하게 된다.
AI순위, 트래픽 기준과 벤치마크 기준이 다르다
AI순위를 이야기할 때 가장 먼저 구분해야 할 건 '무엇을 재는 순위인가'다. 하나는 얼마나 많은 사람이 쓰느냐를 보는 사용량 지표다. 와이즈앱 같은 국내 통계나 a16z의 Top 10 AI 웹/앱 트래픽 데이터가 여기 해당하고, 국내에서는 챗GPT, 퍼플렉시티, 에이닷 등이 상위권에 이름을 올린다.
다른 하나는 실제 작업 수행 능력을 재는 벤치마크 순위다. Artificial Analysis 지능지표(AAII), 코딩 능력을 보는 HumanEval이나 SWE-bench, AICPB 같은 지표가 여기에 속한다. 이 두 순위는 자주 엇갈린다. 사용자 수가 많다고 특정 작업에서 점수가 가장 높은 건 아니고, 벤치마크 1위 모델이 대중적으로 가장 많이 쓰이는 것도 아니다. AI순위를 검색할 때는 '어느 기준의 순위인지'부터 확인하는 게 순서다.
챗GPT·클로드·제미나이, 핵심 차이는 이것이다
대화형 AI 시장에서 계속 비교되는 세 모델은 성격이 뚜렷이 갈린다. 챗GPT는 텍스트 생성과 범용 업무 전반에서 가장 높은 인지도와 글로벌 MAU를 가진 올라운더다. GPT-5 이후 버전들도 이 범용성을 이어가고 있다. 클로드는 긴 문맥을 다루는 능력과 논문·리서치 요약, 그리고 Claude Code를 통한 전문적인 코딩 작업에서 강점을 보인다.
제미나이는 구글 생태계와의 연동성이 핵심으로, Gemini Code Assist 같은 도구로 개발 자동화를 지원하는 쪽에 무게가 실려 있다.
| 구분 | ChatGPT | Claude | Gemini |
|---|---|---|---|
| 강점 영역 | 범용 대화·업무 전반 | 장문 리서치, 코딩 특화 | 구글 서비스 연동, 개발 자동화 |
| 대표 지표 | 글로벌 MAU, 인지도 | HumanEval·SWE-bench 상위권 | 코드 어시스트 생태계 |
| 적합한 사용자 | 일상 대화·범용 업무 | 논문 요약·전문 코딩 | 구글 워크스페이스 사용자 |
표에서 보듯 세 모델은 경쟁 관계라기보다 목적이 다른 도구에 가깝다. 실제로 챗GPT가 여전히 독보적 1위라는 시각과, 코딩·장문 리서치에서는 클로드가 체감상 앞선다는 시각이 공존한다. 여기에 더해 퍼플렉시티는 실시간 검색과 출처 기반 요약에, 커서(Cursor)나 깃허브 코파일럿은 개발자 워크플로 안에서 코드 자동완성에 특화돼 있어 세 모델과는 또 다른 층위의 순위표를 형성한다.
코딩·리서치·한국어, 작업별로 갈리는 1순위
AI순위를 물어보는 사람 대부분은 사실 '내 작업에는 뭐가 맞나'를 궁금해한다. 코딩이라면 Claude Code, Cursor, GitHub Copilot, 그리고 GPT 계열이 SWE-bench·HumanEval 같은 벤치마크에서 상위권을 놓고 경쟁한다. 논문 요약이나 장문 문서 리서치라면 긴 문맥 처리에 강한 Claude가 자주 언급되고, 실시간 사실 확인이 필요한 검색 작업에는 출처 기반 요약에 특화된 Perplexity가 낫다는 평가가 많다.
한국어 자연스러움과 로컬 데이터 이해도를 따진다면 이야기가 또 달라진다. 이 영역에서는 EXAONE, HyperCLOVA X, Solar 같은 국내 LLM이 별도 벤치마크로 비교되는데, 글로벌 모델의 한국어 응답과는 평가축 자체가 다르다. 영상 쪽으로 넘어가면 HeyGen이나 Pika처럼 아바타 영상·숏폼 제작에 특화된 도구가 따로 순위권을 형성한다.
결국 '작업 분야'를 먼저 정하지 않고 AI순위를 검색하면, 서로 다른 목적의 도구들이 뒤섞인 리스트만 보게 된다.
순위 숫자만 보고 고르면 생기는 문제
새 모델이 나올 때마다 벤치마크 순위는 빠르게 바뀐다. 어제 1위였던 모델이 다음 달 발표에서 밀려나는 일이 흔하다. 그래서 특정 시점의 순위표를 절대적인 기준으로 못 박아 소개하는 글은 조심할 필요가 있다. 벤치마크 점수를 높이는 데만 최적화된 모델이 실제 체감 성능과 차이가 나는 경우도 있어서, 점수와 사용 경험이 늘 일치하진 않는다.
선택 전에 짚어볼 만한 것들:
- 이 순위가 사용자 트래픽(MAU) 기준인지, 벤치마크 성능 기준인지부터 확인한다.
- 코딩·리서치·한국어처럼 본인 작업 분야에 맞는 지표인지 본다.
- 무료 제공 범위, 유료 구독 비용, API 응답 지연 시간 등 접근성도 함께 따진다.
- 개별 블로그의 주관적 100점 평가나 특정 모델이 '모든 영역 1위'라는 주장은 그대로 믿지 않는다.
- 검색 상위에 뜨는 유사 사이트나 앱이 공식 채널인지 확인하는 것도 필요하다.
결국 AI순위는 참고 자료이지 절대적인 정답표가 아니다. 트래픽 순위와 벤치마크 순위 중 무엇을 보고 있는지 스스로 구분하는 게 먼저다.
정리하며
AI순위는 '무엇을 재는가'에 따라 완전히 다른 표가 나온다. 일상 대화와 범용 업무라면 챗GPT, 장문 리서치와 코딩이라면 클로드, 구글 환경 안에서 작업한다면 제미나이, 실시간 사실 확인이 필요하면 퍼플렉시티 쪽이 각각 유리하다. 순위 하나로 도구를 정하기보다, 본인 작업이 코딩인지 글쓰기인지 검색인지부터 정한 다음 그 분야의 지표를 찾아보는 편이 실무에는 더 맞는 접근이다.
이렇게 고른 AI 도구로 실제 콘텐츠나 영상을 만드는 단계까지 가면, 그다음은 꾸준히 운영하는 문제가 남는다. 블로그 콘텐츠를 건당 낮은 비용으로 꾸준히 제작하거나, 장면 단위로 통제되는 숏폼·롱폼 영상을 만드는 작업까지 이어가고 싶다면 NEXAFLOW의 콘텐츠·영상 제작 서비스를 참고할 만하다.


댓글
댓글 쓰기